
애플 연구진이 M5 Ultra 맥 스튜디오 4대를 연결해 메타의 대형 언어 모델 ‘Muse Spark Open’을 클라우드 서버 없이 실행했다. 매개변수 8,160억 개 규모의 이 모델은 애플이 시험한 단일 맥 스튜디오에 들어가지 않았다. 연구진은 모델을 여러 대에 나눠 올려 8,192토큰 문맥에서 초당 36.73토큰을 생성했다.
같은 모델을 맥 스튜디오 2대와 4대에서 비교
연구진은 애플 실리콘용 머신러닝 프레임워크 MLX를 사용했다. 맥 사이에는 Thunderbolt 5 기반 RDMA를 적용해 연산에 필요한 데이터를 교환했다. 파이프라인 병렬화는 모델의 층을 여러 기기에 나눠 순차적으로 처리하고, 텐서 병렬화는 개별 층의 계산을 여러 기기에 분담한다.
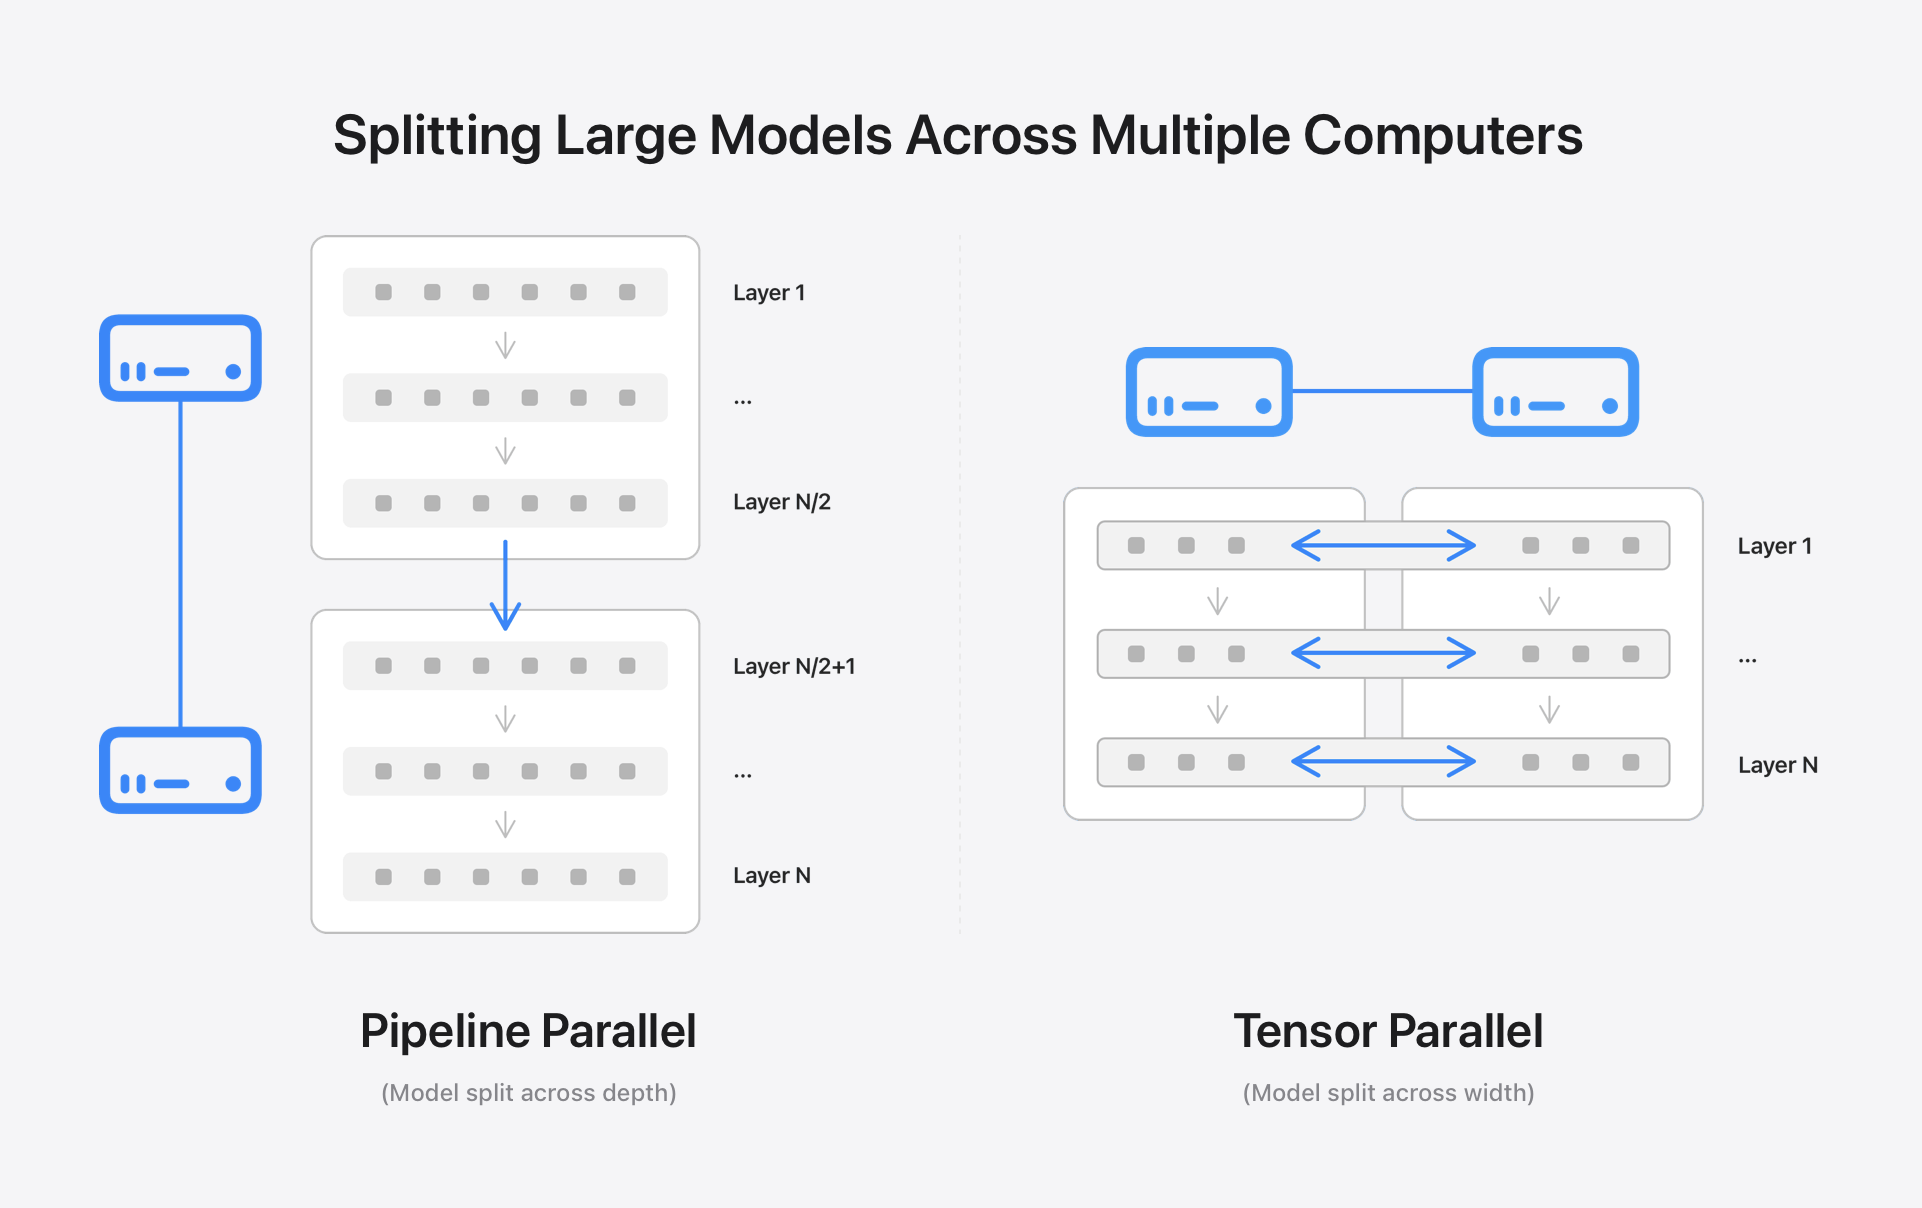
Muse Spark Open은 원래 정밀도인 BF16에서 모델 가중치만 1.6TB 넘게 필요하다. 애플은 4비트 양자화(NVFP4)로 약 493GB까지 줄였지만, 추론 중간 결과를 저장할 공간까지 합하면 512GB 맥 스튜디오 한 대에 들어가지 않았다. 파이프라인 방식은 층 묶음 사이에서만 중간 결과를 전달하는 반면, 텐서 방식은 각 층에서 연산 결과를 합쳐야 해 기기 간 통신 지연에 더 민감하다.
| M5 Ultra 구성 | 첫 토큰까지 | 생성 속도 |
|---|---|---|
| 2대 · 파이프라인 병렬화 | 8.4초 | 15.74토큰/초 |
| 2대 · 텐서 병렬화 | 8.2초 | 24.99토큰/초 |
| 4대 · 텐서 병렬화 | 4.8초 | 36.73토큰/초 |
표는 문맥 길이 8,192토큰에서 측정한 결과다. 생성 속도는 입력 문맥을 처리한 뒤 이어서 생성한 128개 토큰을 기준으로 했다. 같은 텐서 병렬화 방식에서 2대를 4대로 늘리자 생성 속도는 약 47% 높아졌고, 첫 토큰까지 걸리는 시간은 8.2초에서 4.8초로 줄었다.
첫 응답과 이후 생성 속도는 다른 지표
첫 토큰까지 걸리는 시간은 모델이 입력을 처리해 답변을 시작하기까지의 대기 시간이다. 초당 생성 토큰 수는 답변을 시작한 뒤 텍스트가 나오는 속도를 뜻한다. 입력 문맥 길이나 모델, 기기 간 통신 비용에 따라 두 지표는 다르게 변할 수 있다.
애플은 문맥을 65,536토큰으로 늘린 조건도 별도로 측정했다. 긴 문맥에서는 기기 간 통신 비용이 커져, 두 대 구성에서 텐서 병렬화가 파이프라인 병렬화보다 입력 처리에 더 오래 걸리는 경우도 있었다. 연구 자료에는 다른 모델과 문맥 길이별 비교도 수록됐다.
65,536토큰 문맥에서 M5 Ultra 맥 스튜디오 4대를 텐서 병렬화로 연결했을 때, 기기 쌍마다 Thunderbolt 케이블을 한 개에서 두 개로 늘리자 첫 토큰까지 걸린 시간이 약 50.5초에서 40.6초로 줄었다. 이는 긴 입력을 처리하는 단계의 비교이며, 앞 표의 8,192토큰 조건이나 이후 토큰 생성 속도와는 별개다.
출처: Apple Machine Learning Research 원문
관련 자료: 9to5Mac 후속 기사
Apple Newsroom: M5 Ultra 맥 스튜디오
KMUG 애플에 대한 모든 것.
Apple 케이머그 김영권
https://kmug.com
KMUG 케이머그에서 더 알아보기
구독을 신청하면 최신 게시물을 이메일로 받아볼 수 있습니다.
댓글을 달려면 로그인해야 합니다.